|
| 商品編號: | DCM8144 | |
| 商品名稱: | Python不廢話 一行程式碼:像高手般寫出簡潔有力的Python程式碼 出版公司:碁峰資訊 作者:Christian Mayer 類型:電腦資訊-程式設計 PDF電子書 繁體中文版 | | | 語系版本: | PDF電子書 繁體中文版 | |
| 運行平台: | PDF電子書,沒有任何平台限制,終身使用 | |
| 更新日期: | 2026-05-01 | |
| 光碟片數: | 1片CD光碟 | |
| 銷售價格: | $100元 | |
| 熱門標籤: | Python不廢話
一行程式碼
碁峰資訊
電腦資訊
程式設計
Christian
Mayer
| |
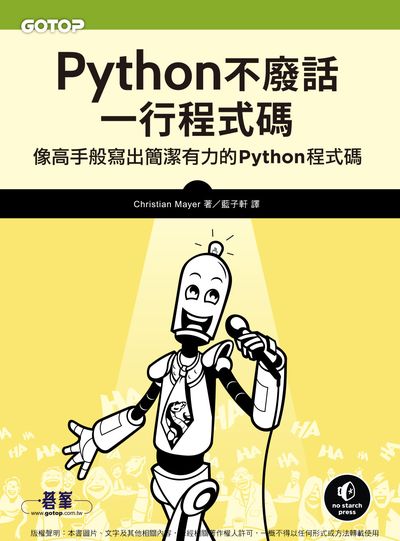
Python不廢話 一行程式碼:像高手般寫出簡潔有力的Python程式碼 出版公司:碁峰資訊 作者:Christian Mayer 類型:電腦資訊-程式設計 PDF電子書 繁體中文版
商品資料
作者:Christian Mayer
出版社:峰資訊
出版年:2022
課程類型:電腦資訊>程式設計
檔案格式:PDF
ISBN:9789865029296
書籍簡介
本書將告訴你如何讀懂並寫出簡潔的「一行程式碼」,把一些好用的功能包進一行程式碼之中。你可以學會如何以系統化的方式,閱讀理解任何Python程式碼,並像高手般寫出極具表現力、功能強大、簡潔有力的Python程式。全書共有六章,內容涵蓋各種竅門與技巧,其中包括資料科學、機器學習、正則表達式等核心主題,還有一些很好用的演算法。我們會針對各種一行程式碼做出詳細解釋,並引進許多資訊科學的重要概念,藉此提高你的程式設計與分析能力。
您可以從裡頭學到許多進階的Python功能,例如解析式列表、切取資料片段、lambda函式、正則表達式、map與reduce函式,以及切取片段賦值的做法。
藉由本書,您將可以學會如何:
.善用資料結構來解決實際問題,如運用布林索引找出污染程度高於平均的城市
.善用NumPy的基礎概念,例如陣列、形狀、軸、型別、撒播機制、進階索引、切取片段、排序、搜索、匯整與統計
.計算多維資料陣列的基本統計數字,以及可用於無監督式學習的K-均值演算法
.使用群組與具名群組、「後面非」操作、轉義字元、空白字元、字元集合(與否定字元集合)、貪婪/非貪婪運算符號,建立更進階的正則表達式
.瞭解各式各樣的資訊科學相關主題,包括易位構詞、迴文、冪集合、排列方式、階乘、質數、費氏數列、混淆做法、搜索與排序演算法
看完本書,你可以學會如何以最精緻的方式寫好Python程式,而且只用一行程式碼,就可以創造出各種簡潔而優美的「Python藝術」。
作者簡介
作者簡介
Christian Mayer
Christian Mayer是一位資訊科學博士。他所創立的網站:blog.finxter.com,提供許多Python教學內容,極受歡迎,目前這個網站約有2萬名活躍的訂閱者,而且人數還在持續增加中。這個快速茁壯的網站已經幫助成千上萬的學生提高了程式設計技能,並為許多人的工作提供不少助益。
章節
致謝(第ix頁)前言(第xi頁)1 Python 複習課(第1頁)- 基本資料結構(第2頁)
- 容器資料結構(第8頁)
- 流程控制(第18頁)
- 函式(第21頁)
- lambda 匿名函式(第22頁)
- 小結(第23頁)
2 Python 小技巧(第25頁)- 用解析式列表找出收入最高的人(第26頁)
- 用解析式列表找出資訊價值比較高的單詞(第30頁)
- 讀取檔案(第32頁)
- 善用 lambda 和 map 函式(第35頁)
- 用切取片段的做法,比對出相符子字串與前後文(第38頁)
- 解析式列表結合切取片段的做法(第43頁)
- 用切取片段賦值的方式,修正損壞的列表(第45頁)
- 用列表串接的做法,分析心臟健康資料(第48頁)
- 用生成器表達式找出薪水低於最低薪資的公司(第51頁)
- 用 zip() 函式來轉換資料的格式(第54頁)
- 小結(第57頁)
3 資料科學(第59頁)- 二維陣列的基本運算(第60頁)
- 活用 NumPy 陣列:切取片段、撒播機制、陣列型別(第66頁)
- 用布林索引篩選二維陣列(第82頁)
- 用撒播機制、切取片段賦值和重新調整形狀的技巧,清理陣列中每一個第 i 元素(第85頁)
- 何時該用 sort() 函式、何時該用 argsort() 函式(第91頁)
- 如何用 lambda 函式與布林索引來篩選陣列(第96頁)
- 如何運用統計、數學與邏輯,建立高級陣列篩選器(第99頁)
- 簡單的關聯性分析:購買 X 的人也購買了 Y(第106頁)
- 用中級關聯分析技巧找出暢銷產品組合(第109頁)
- 小結(第113頁)
4 機器學習(第115頁)- 監督式機器學習的基礎知識(第116頁)
- 線性迴歸(第118頁)
- 邏輯迴歸(第126頁)
- K 均值集群處理(第133頁)
- K 最近鄰(第140頁)
- 神經網路分析(第146頁)
- 決策樹學習(第156頁)
- 取出變異量最小的資料行(第160頁)
- 一些基本的統計量(第164頁)
- 用支撐向量機進行分類(第169頁)
- 用隨機森林進行分類(第173頁)
- 小結(第178頁)
5 正則表達式(第179頁)- 在字串中找出基本的文字特定模式(第180頁)
- 用正則表達式寫出你的第一個網路爬蟲(第186頁)
- 分析 HTML 文件裡的超鏈結(第190頁)
- 從字串中提取出金額數字(第195頁)
- 找出不安全的 HTTP 網址(第198頁)
- 驗證使用者所輸入的時間格式(第一種做法)(第200頁)
- 驗證使用者所輸入的時間格式(第二種做法)(第203頁)
- 偵測出字串中的重複部分(第205頁)
- 偵測出單詞重複出現的情況(第208頁)
- 修改多行字串中符合特定模式的文字(第211頁)
- 小結(第213頁)
6 演算法(第215頁)- 用 lambda 函式與排序的技巧找出易位構詞(第217頁)
- 用 lambda 函式與負向切取片段的技巧找出迴文(第220頁)
- 用遞迴型階乘函式計算排列方式的數量(第222頁)
- 計算 Levenshtein 距離(第227頁)
- 用函式型程式設計方式計算冪集合(第232頁)
- 用進階索引與解析式列表進行凱撒密碼加密(第236頁)
- 用艾氏篩法找出質數(第240頁)
- 用 reduce() 函式計算費氏數列(第248頁)
- 二元搜尋遞迴演算法(第251頁)
- 快速排序遞迴演算法(第256頁)
- 小結(第259頁)
後記(第260頁)
|



 您現在的位置:
 電子書綜合教學

